Ponytail、Cavemanの使用レビュー
最近話題のPonytailとCavemanを3か月使った感想
概要
会社でAIをうまく活用している人を見ると、いつもトークン使用量の上限に達し、足りなければ個人契約までして使っている。私もこの業界の流れについていくため、仕事ではできるだけAIを使おうとしている。
うまく使うにはまず知る必要があると思い、トレンドを調べたところ、PonytailとCavemanというプラグインが話題になっていた。AIを定量的にどう評価すべきかはまだ分からないため、ここでは自分が感じたことを主観的にまとめる。
テスト環境
- AIツール: Codex
- モデル: gpt-5.6-terra
- 推論レベル: Medium
Ponytail
紹介
AIを使っていると、指示していない機能や、そのスコープでは意味のない防御的なコードまで作ってしまうことがある。私はコミット直前にそうした部分を自分で確認しているが、それなりに時間がかかる。
この問題を解決するために登場したプラグインがPonytailだ。
You know him. Long ponytail. Oval glasses. Has been at the company longer than the version control. You show him fifty lines; he looks at them, says nothing, and replaces them with one.
Ponytail puts him inside your AI agent.
どのように動くのか?
Skillの動作
1. Does this need to exist?   → no: skip it (YAGNI)
2. Already in this codebase?  → reuse it, don't rewrite
3. Stdlib does it?            → use it
4. Native platform feature?   → use it
5. Installed dependency?      → use it
6. One line?                  → one line
7. Only then: the minimum that works
Ponytailは、AIが短いコードを書けるよう、次の段階を検証する。
- その機能は必要か?
- すでにコードベースにある機能か?
- 標準ライブラリでできるか?
- HTMLやOSなど、プラットフォームにすでにある機能か?
- すでに導入済みの依存関係で実現できるか?
- 1行のコードでできるか?
- それ以外の場合だけ、動く最小限のコードで実装する。
この段階を踏むことで、不要なコードの生成を防げる。
強度調整モード
/ponytail [lite | full | ultra | off]
テスト1(Full vs Off)
このブログのヘッダーに直接機能を追加するよう指示した。
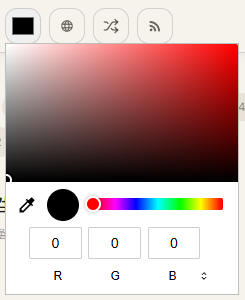
Prompt: color-accentを調整するColorPickerコンポーネントを作り、上部のナビゲーションに追加して。
Full
<input
  type="color"
  defaultValue="#e64900"
  aria-label="Choose accent color"
  onChange={(event) =>
    document.documentElement.style.setProperty("--color-accent", event.target.value)
  }
/>
Off
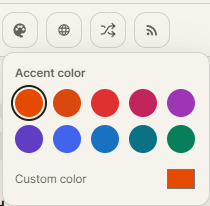
Ponytailを無効にすると、Headless UIのPopover、あらかじめ定義した色のパレット、localStorageへの保存、カスタムカラーの選択、アルファ値付きカラーまで実装された。
結果の分析
- Full: カラーピッカーとCSS変数の変更という要求だけを実装した。
- Off: Popover、定義済みのカラーパレット、localStorage、カスタムカラー、アルファカラーなどの追加機能を実装した。
実務では企画書どおりに開発すべきで、AIの想像が加わるべきではない。そのため、要求だけを実装したFullのほうが好みだった。
テスト2(Full vs Lite)
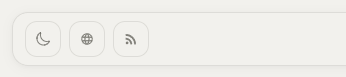
Prompt: 上部ナビゲーションのRSSの左に、ランダムな投稿へ移動するボタンを追加して。
Full
window.location.assign(hrefs[Math.floor(Math.random() * hrefs.length)])Lite
import { useRouter } from "@/i18n/navigation"

router.push(hrefs[Math.floor(Math.random() * hrefs.length)])
結果の分析
- Full: ページ遷移に
window.location.assign()を使用した。 - Lite: ページ遷移に
useRouter()を使用した。
これは興味深い結果だった。Next.jsではuseRouter()を使うと不要な再レンダリングを避けられ、実際のプロジェクトの慣例もuseRouter()だった。この点ではLiteの勝ちだ。
テスト3(Spring Framework、Lite vs Off)
Prompt: プロジェクトにファイルアップロード機能を追加して。ファイルシステムには保存せず、メモリ上だけに置いて。
Lite
ConcurrentHashMapにバイト列とファイル名だけを保存し、エラーにはSpring標準のResponseStatusExceptionを使用した。
Off
Content-Typeも保存し、既存プロジェクトのBizExceptionとFileErrorCodeの慣例を使用した。
結果の分析
- Lite: 最小限の情報だけを保存し、Spring標準の例外を使用した。
- Off: Content-Typeも保存し、既存プロジェクトの例外設計を活用した。
プロンプトにそのコンテキストを含めていなくても、Offはカスタムエラーコードを使うべきだと判断し、プロジェクトにより適合する実装を作った。Offの勝ちだ。
結論
- ColorPickerの実装では、要求だけを実装したFullの結果がよかった。
- ルーティングボタンの実装では、Next.jsの考え方に沿ったLiteがよかった。
- ファイルサービスの実装では、既存のプロジェクト構造を理解したOffがよかった。
Ponytailは期待したほど良い結果を出さなかった。プロンプトの具体性が足りなかったことが原因かもしれない。指示どおりに非常に忠実に実装するため、テスト2と3では不正解に近い結果を出したことがあった。
ハーネスやClaude.mdのようなものを使ってプロンプトをより具体的にすれば、有用に使えるかもしれない。Ponytailをうまく使うには、より具体的なプロンプトが必要だと思う。
追加機能: audit / review
Ponytailは、現在のプロジェクトやコミットにある膨らんだコードも指摘してくれる。
/ponytail-audit   # プロジェクトのソースを監査
/ponytail-review  # 最新コミットをレビュー
テスト出力
stdlib: 未使用のMyBatis設定と2つの依存関係を削除。永続化層ではJPAだけを使用している。
delete: 注入も呼び出しもされないRestClient Beanと、専用のApache HttpClient依存関係を削除。
delete: 空のUserCommandServiceを削除。代替は不要。
yagni: 実装が1つだけのErrorCodeインターフェースを削除。別の実装が必要になったときだけ戻す。
net: およそ45行と直接依存関係3つを削減可能。最近は/ponytail-reviewを使い、コミット直前に不要なコードが入り込んでいないか確認する用途だけで使っている。
Caveman
紹介
Cavemanは、AIが回答するときに短く、原始人のように話すようにするプラグインだ。
why use many token when few do trick Make your AI coding agent talk like a caveman. Same answers, 65% fewer output tokens. Brain still big. Mouth small.
どのように動く?
推論には介入せず、最終回答だけに介入して、短く原始人のように話させる。
リポジトリで説明されている期待効果は2つある。
- 回答で使うトークン数を減らす。
- 要点だけを生成することで、人が文章を理解するまでの時間を減らせる。
テスト
Prompt: DB設計中に非正規化を選ぶべきケースを教えて。
Off
通常の回答では、読み取り負荷が高いワークロード、高コストなJOINや集約、厳しいレイテンシ要件、過去の値のスナップショット、分散システムへの依存の削減を説明していた。また、非正規化の前に必要となる信頼できるデータソース、更新戦略、許容できる古さ、不整合の修復、計測についても扱っていた。
Full
Fullの回答は、ダッシュボード、検索API、大規模なJOIN、履歴スナップショット、分散DBやキャッシュ、高コストな繰り返し計算という実践的なケースに要約していた。計測で確認した読み取りボトルネック、更新ルール、不整合からの復旧、インデックスやキャッシュといった代替策を検証するよう勧めていた。
Lite
Liteの回答はさらに短い。書き込みコストより読み取り性能が重要なときに非正規化を選び、頻繁なJOIN・集約、厳しいレイテンシ目標、反復計算、レポート、非同期更新データ、CQRSやマテリアライズドビューのような読み書きモデルの分離で使うとしていた。元のデータは正規化したまま保ち、重複フィールドは派生値として扱う。
3か月使った感想
- 使っていなかったときは、出力が長すぎて要点を把握するのが面倒だった。
- Fullは短答すぎて、新しく知る概念では文章を読みにくいことがあった。
- 個人的にはLiteの回答品質がちょうどよく、これを使っている。
余談
Cavemanは実測すると、むしろトークン使用量が増えるというベンチマークがある。
Does Caveman Actually Save Tokens? I Built a Benchmark to Find Out
- スキルのロードにより、Cavemanを有効にした時点で初期コンテキストが増加する。
- 短いセッションでは初期オーバーヘッドが大きく、Cavemanを使う利点がほとんどなくなる可能性がある。
要するに、トークン使用量は重要ではなく、むしろ増えることもある。短い回答によって要点を把握するまでの認知時間を減らせることが、本当の利点だ。